Contenido para dejar atrás los datos dispersos
Para empresas que quieren centralizar sus datos, reducir los reportes manuales y crear bases confiables para BI, APIs y decisiones.
Pipelines de datos: qué son y por qué automatizar la ingesta
Un pipeline de datos es el camino automático que lleva el dato desde la fuente hasta una base lista para el análisis. Conoce las etapas y por qué automatizar cambia el juego.
Qué es un datalake y por qué tu empresa podría necesitarlo
Un datalake es el lugar central donde los datos de todos tus sistemas por fin se conectan. Entiende el concepto sin jerga y descubre cuándo tiene sentido para tu empresa.
Ingesta programada: cómo mantener tus datos siempre actualizados
La ingesta programada hace que los datos lleguen solos a tu entorno central, con la frecuencia correcta. Mira cómo definirla sin exagerar en el costo.
¿Tus datos están dispersos? Las señales de que eso está frenando a tu empresa
Los datos descentralizados casi nunca aparecen como un "problema de datos": aparecen como retrabajo, reuniones para conciliar números y decisiones atrasadas. Aprende a reconocer las señales.
APIs, webhooks y service accounts: cómo entregar datos a otros sistemas
Los dashboards no son el único destino de tus datos. APIs, webhooks y service accounts entregan datos a sistemas y automatizaciones — entiende cuándo usar cada uno.
Antes de Power BI, la base: por qué los dashboards fallan cuando los datos están desordenados
Muchas empresas compran BI esperando resolver su problema de datos — y descubren que el gráfico solo hizo más visible el desorden. La base va antes del dashboard.
LGPD en la práctica: qué cuidar al centralizar los datos de la empresa
Centralizar datos de clientes da poder de análisis — y responsabilidad ante la LGPD. Conoce buenas prácticas para hacerlo con cuidado, sin volverte experto legal.
¿Cuánto cuesta montar una estructura de datos desde cero?
El costo de una estructura de datos propia va mucho más allá de la nube. Conoce los componentes que suelen olvidarse y por qué el modelo self-service cambia la cuenta.
Un datalake sin equipo de datos: ¿es posible?
No necesitas un área de datos armada para empezar a centralizar información. Mira hasta dónde llegas con una plataforma self-service y cuándo vale la pena ampliar el equipo.
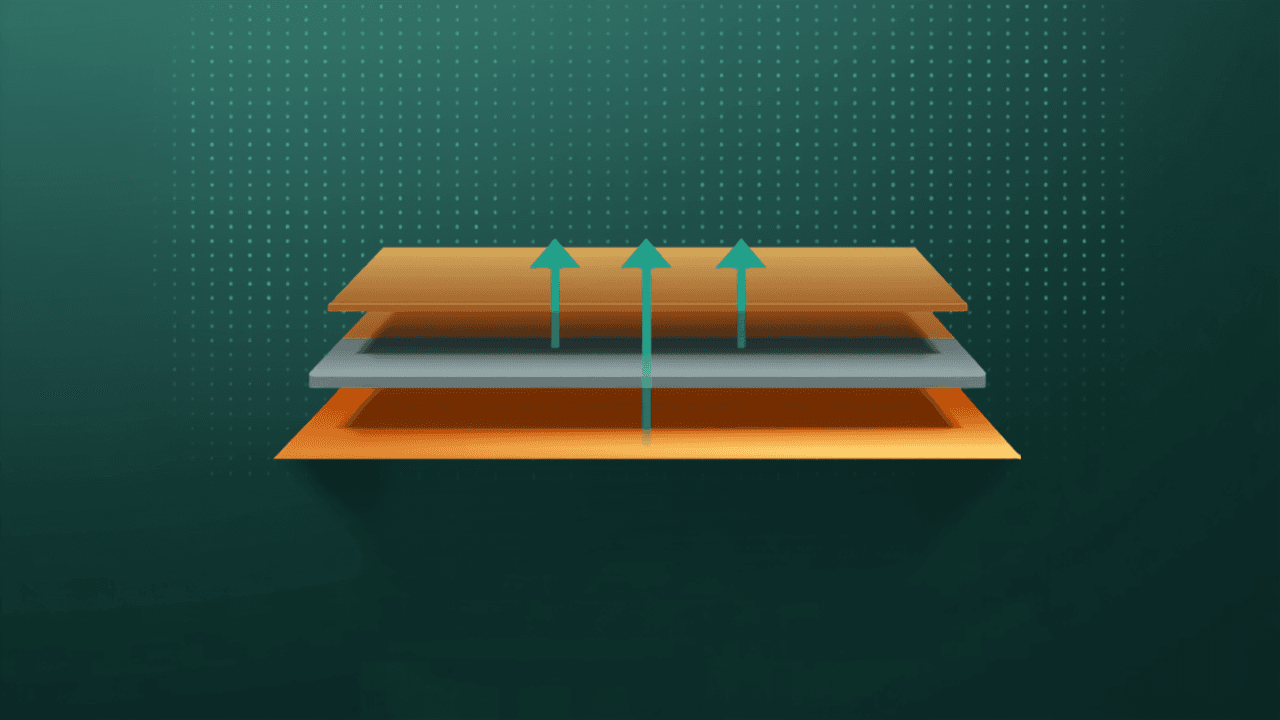
Bronze, Silver y Gold: cómo organizar tus datos de forma simple
Bronze, Silver y Gold es solo una forma ordenada de separar el dato bruto, el dato tratado y el dato listo para el reporte. Entiende el concepto con ejemplos del día a día.
Cómo centralizar datos de ERP, hojas de cálculo, bases de datos y sistemas internos
Centralizar datos no es mover todo de una vez. Es conectar cada fuente con la frecuencia correcta y organizarlas en un solo lugar. Mira el paso a paso práctico.
Por qué los reportes manuales en hojas de cálculo cuestan más de lo que parece
La hoja de cálculo no es la villana, pero armar reportes a mano cada mes tiene un costo que rara vez aparece en el presupuesto. Mira dónde se esconde.
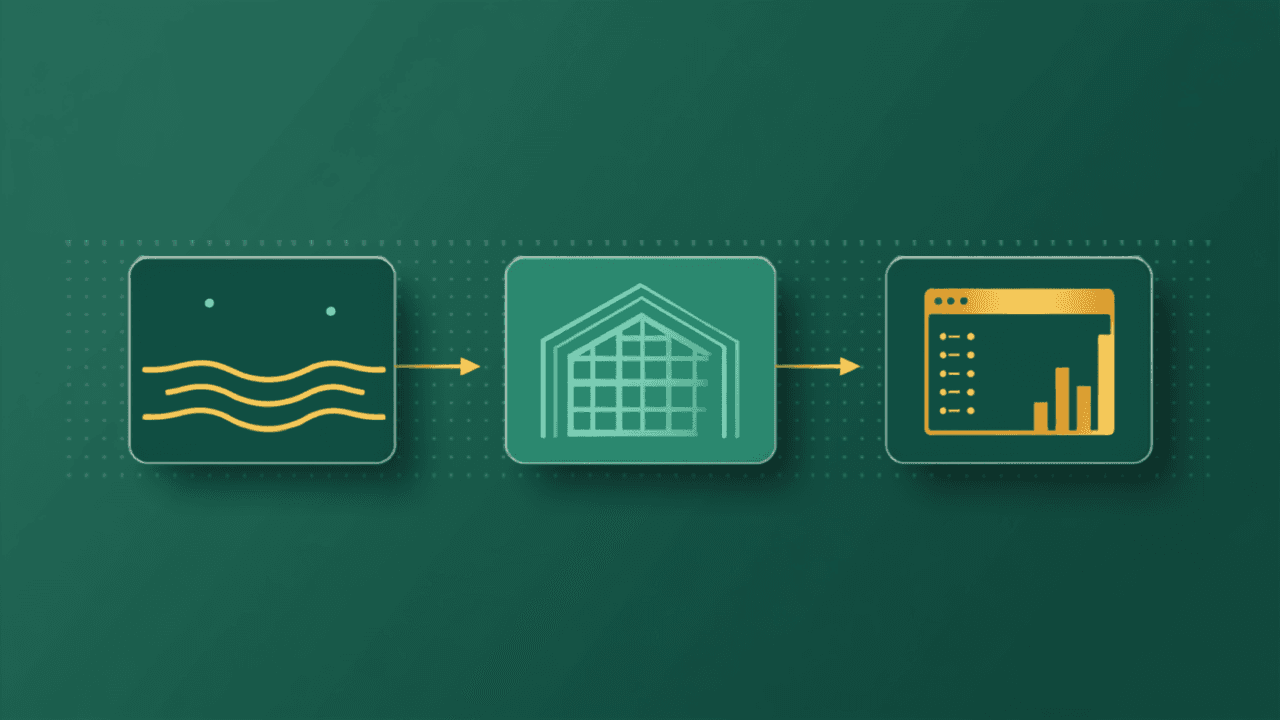
Data lake, data warehouse y BI: ¿cuál es la diferencia?
Data lake, data warehouse y BI no compiten entre sí: son etapas de un mismo camino. Entiende el papel de cada uno sin perderte en los términos.
Cómo controlar los costos de datos en la nube
La factura que crece sola es uno de los mayores miedos de quien lleva sus datos a la nube. Conoce prácticas que dan previsibilidad y evitan sorpresas.
Cómo preparar datos para Power BI, Looker Studio y Tableau
El secreto de un buen dashboard está en la base que lo alimenta. Descubre cómo preparar los datos para que Power BI, Looker Studio y Tableau brillen.
Control de acceso y PII: por qué la seguridad debe estar en tu estructura de datos desde el inicio
La seguridad de datos no es algo para agregar después. Cuando centralizas información sensible, el control de acceso y la gobernanza de PII deben estar desde la base.
¿No sabes por dónde empezar?
Haz el Simulador de Estructura de Datos y descubre qué plan de ingestia.io tiene sentido para tu empresa.